Het probleem
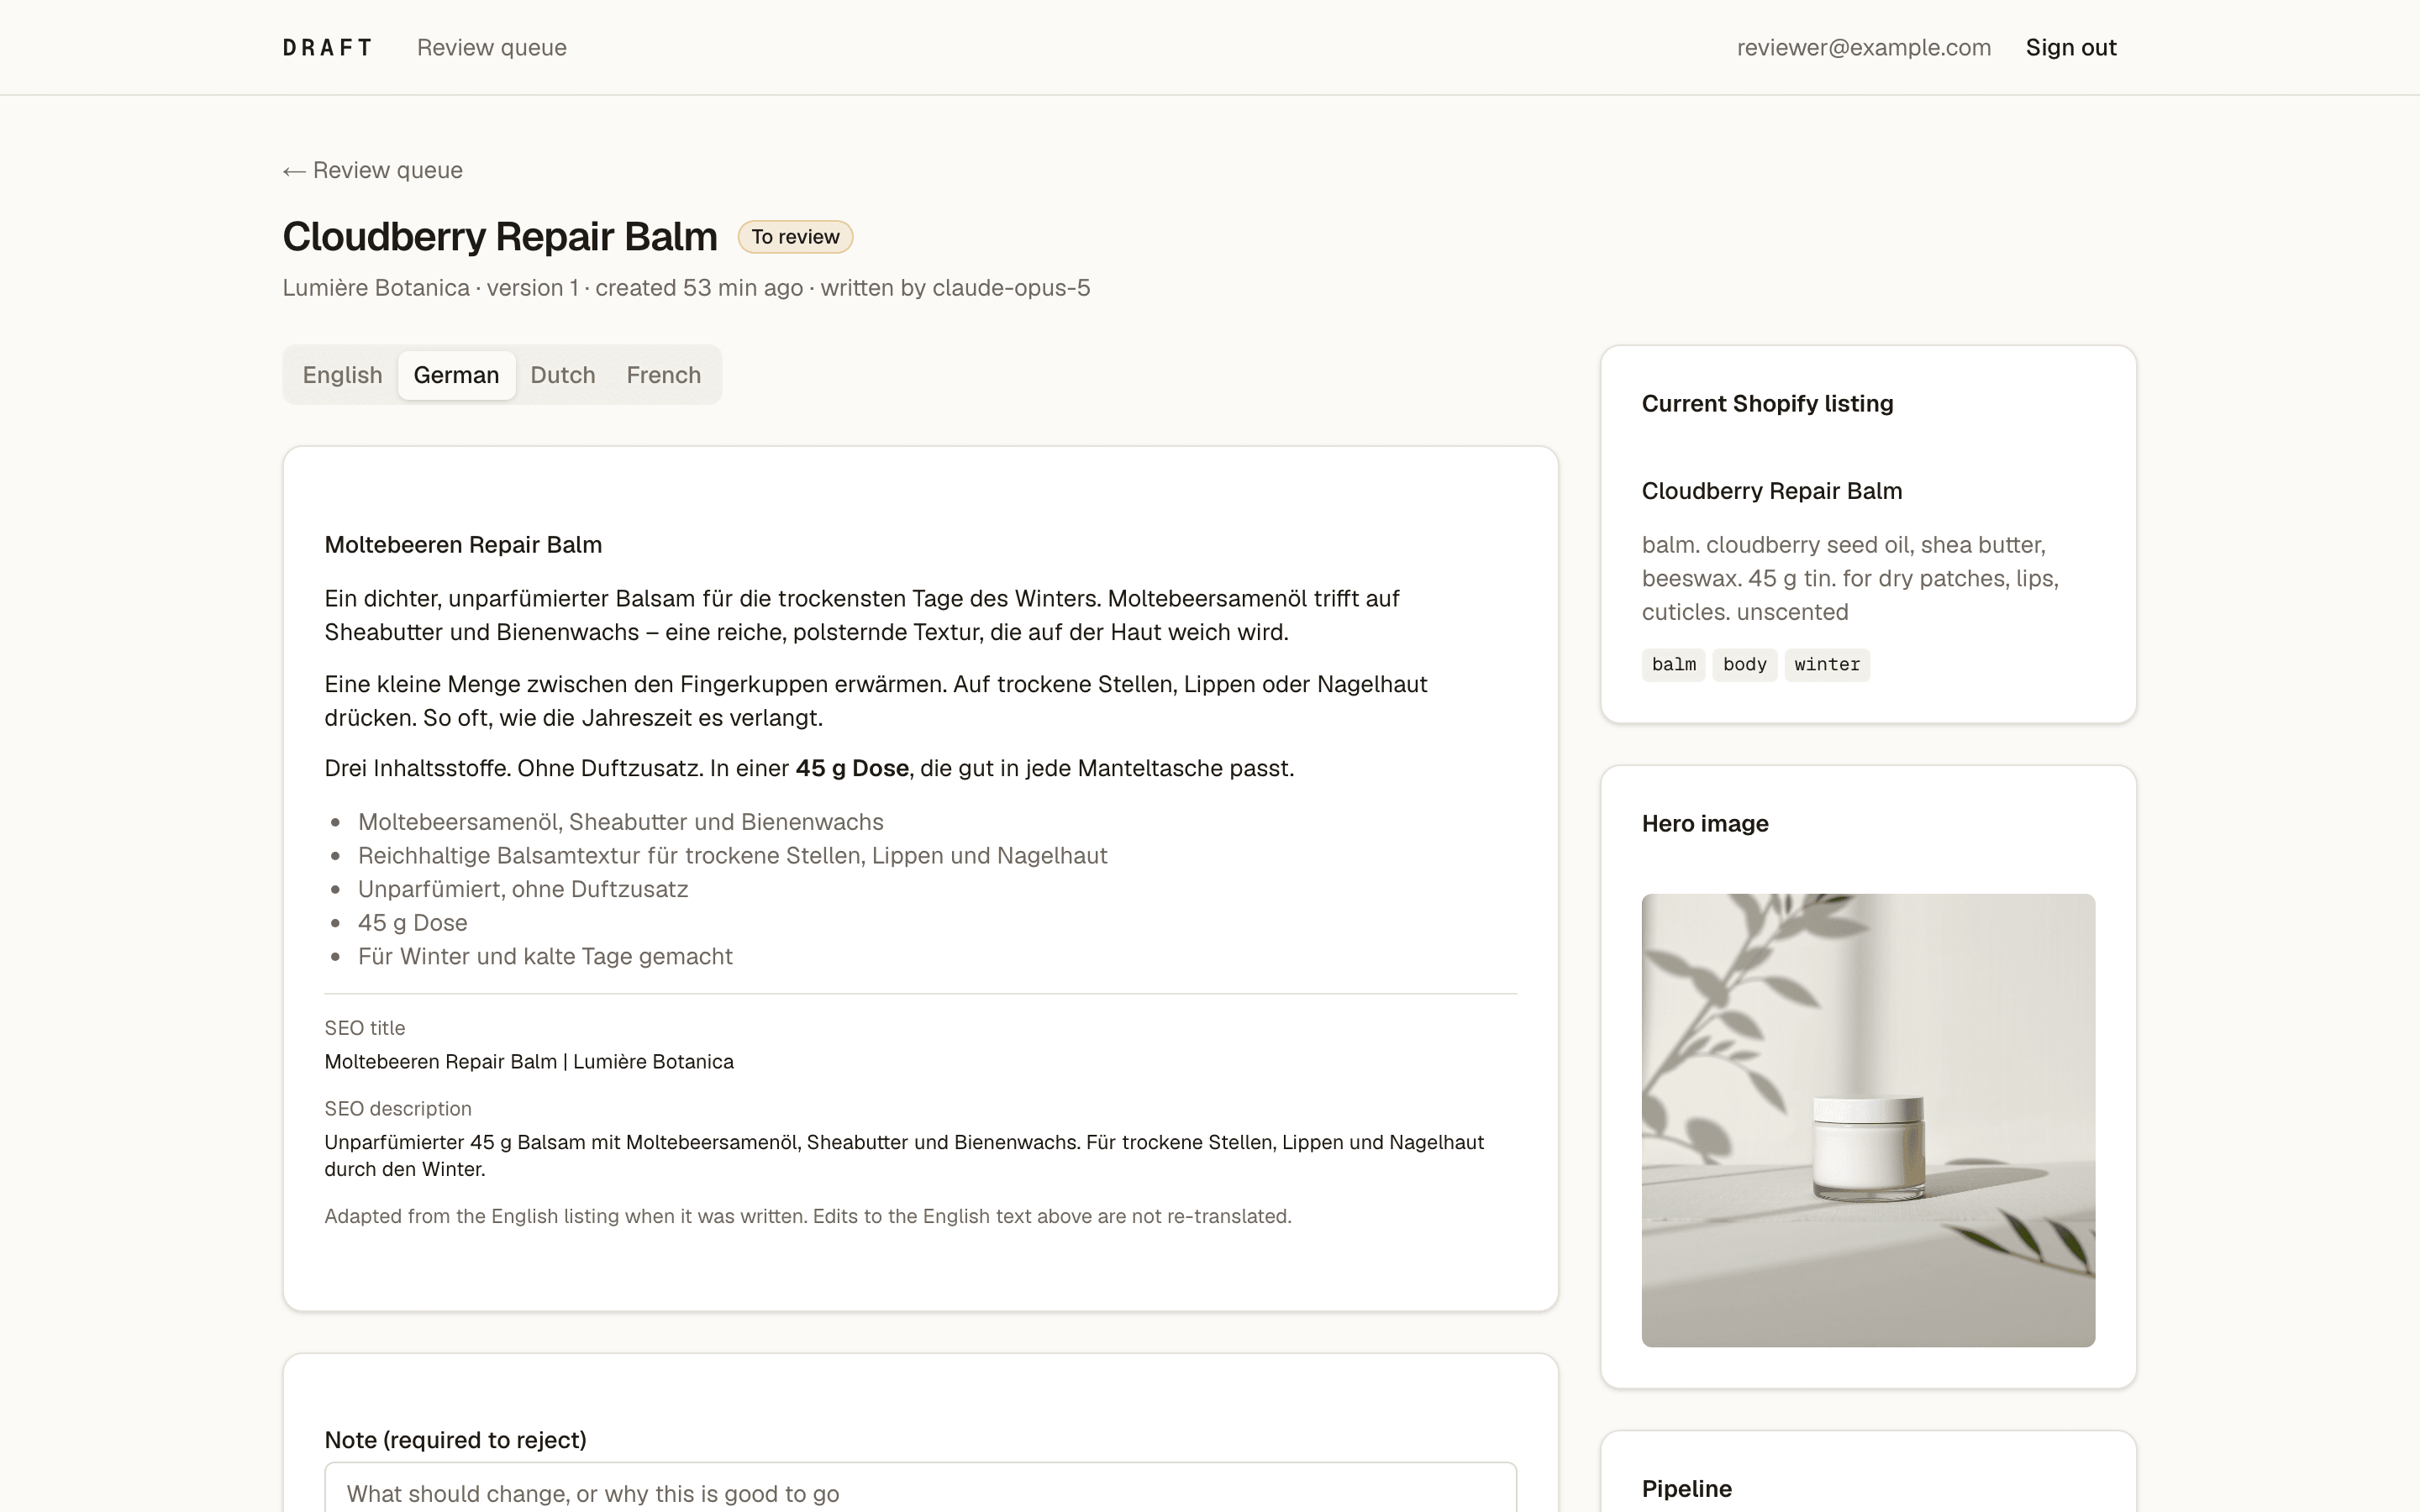
Het bedrijf verkoopt meerdere merken via één Shopify-webshop, in vier talen, en er komen merken bij. Elke producttekst werd met de hand geschreven en daarna opnieuw in het Duits, Nederlands en Frans, elke keer met een eigen SEO-titel en meta-omschrijving. Daar ging ongeveer vier uur per dag in zitten, en een merk erbij betekende dat hele werk er nog een keer bij, dus het werk groeide harder dan de catalogus.
Wat we bouwden
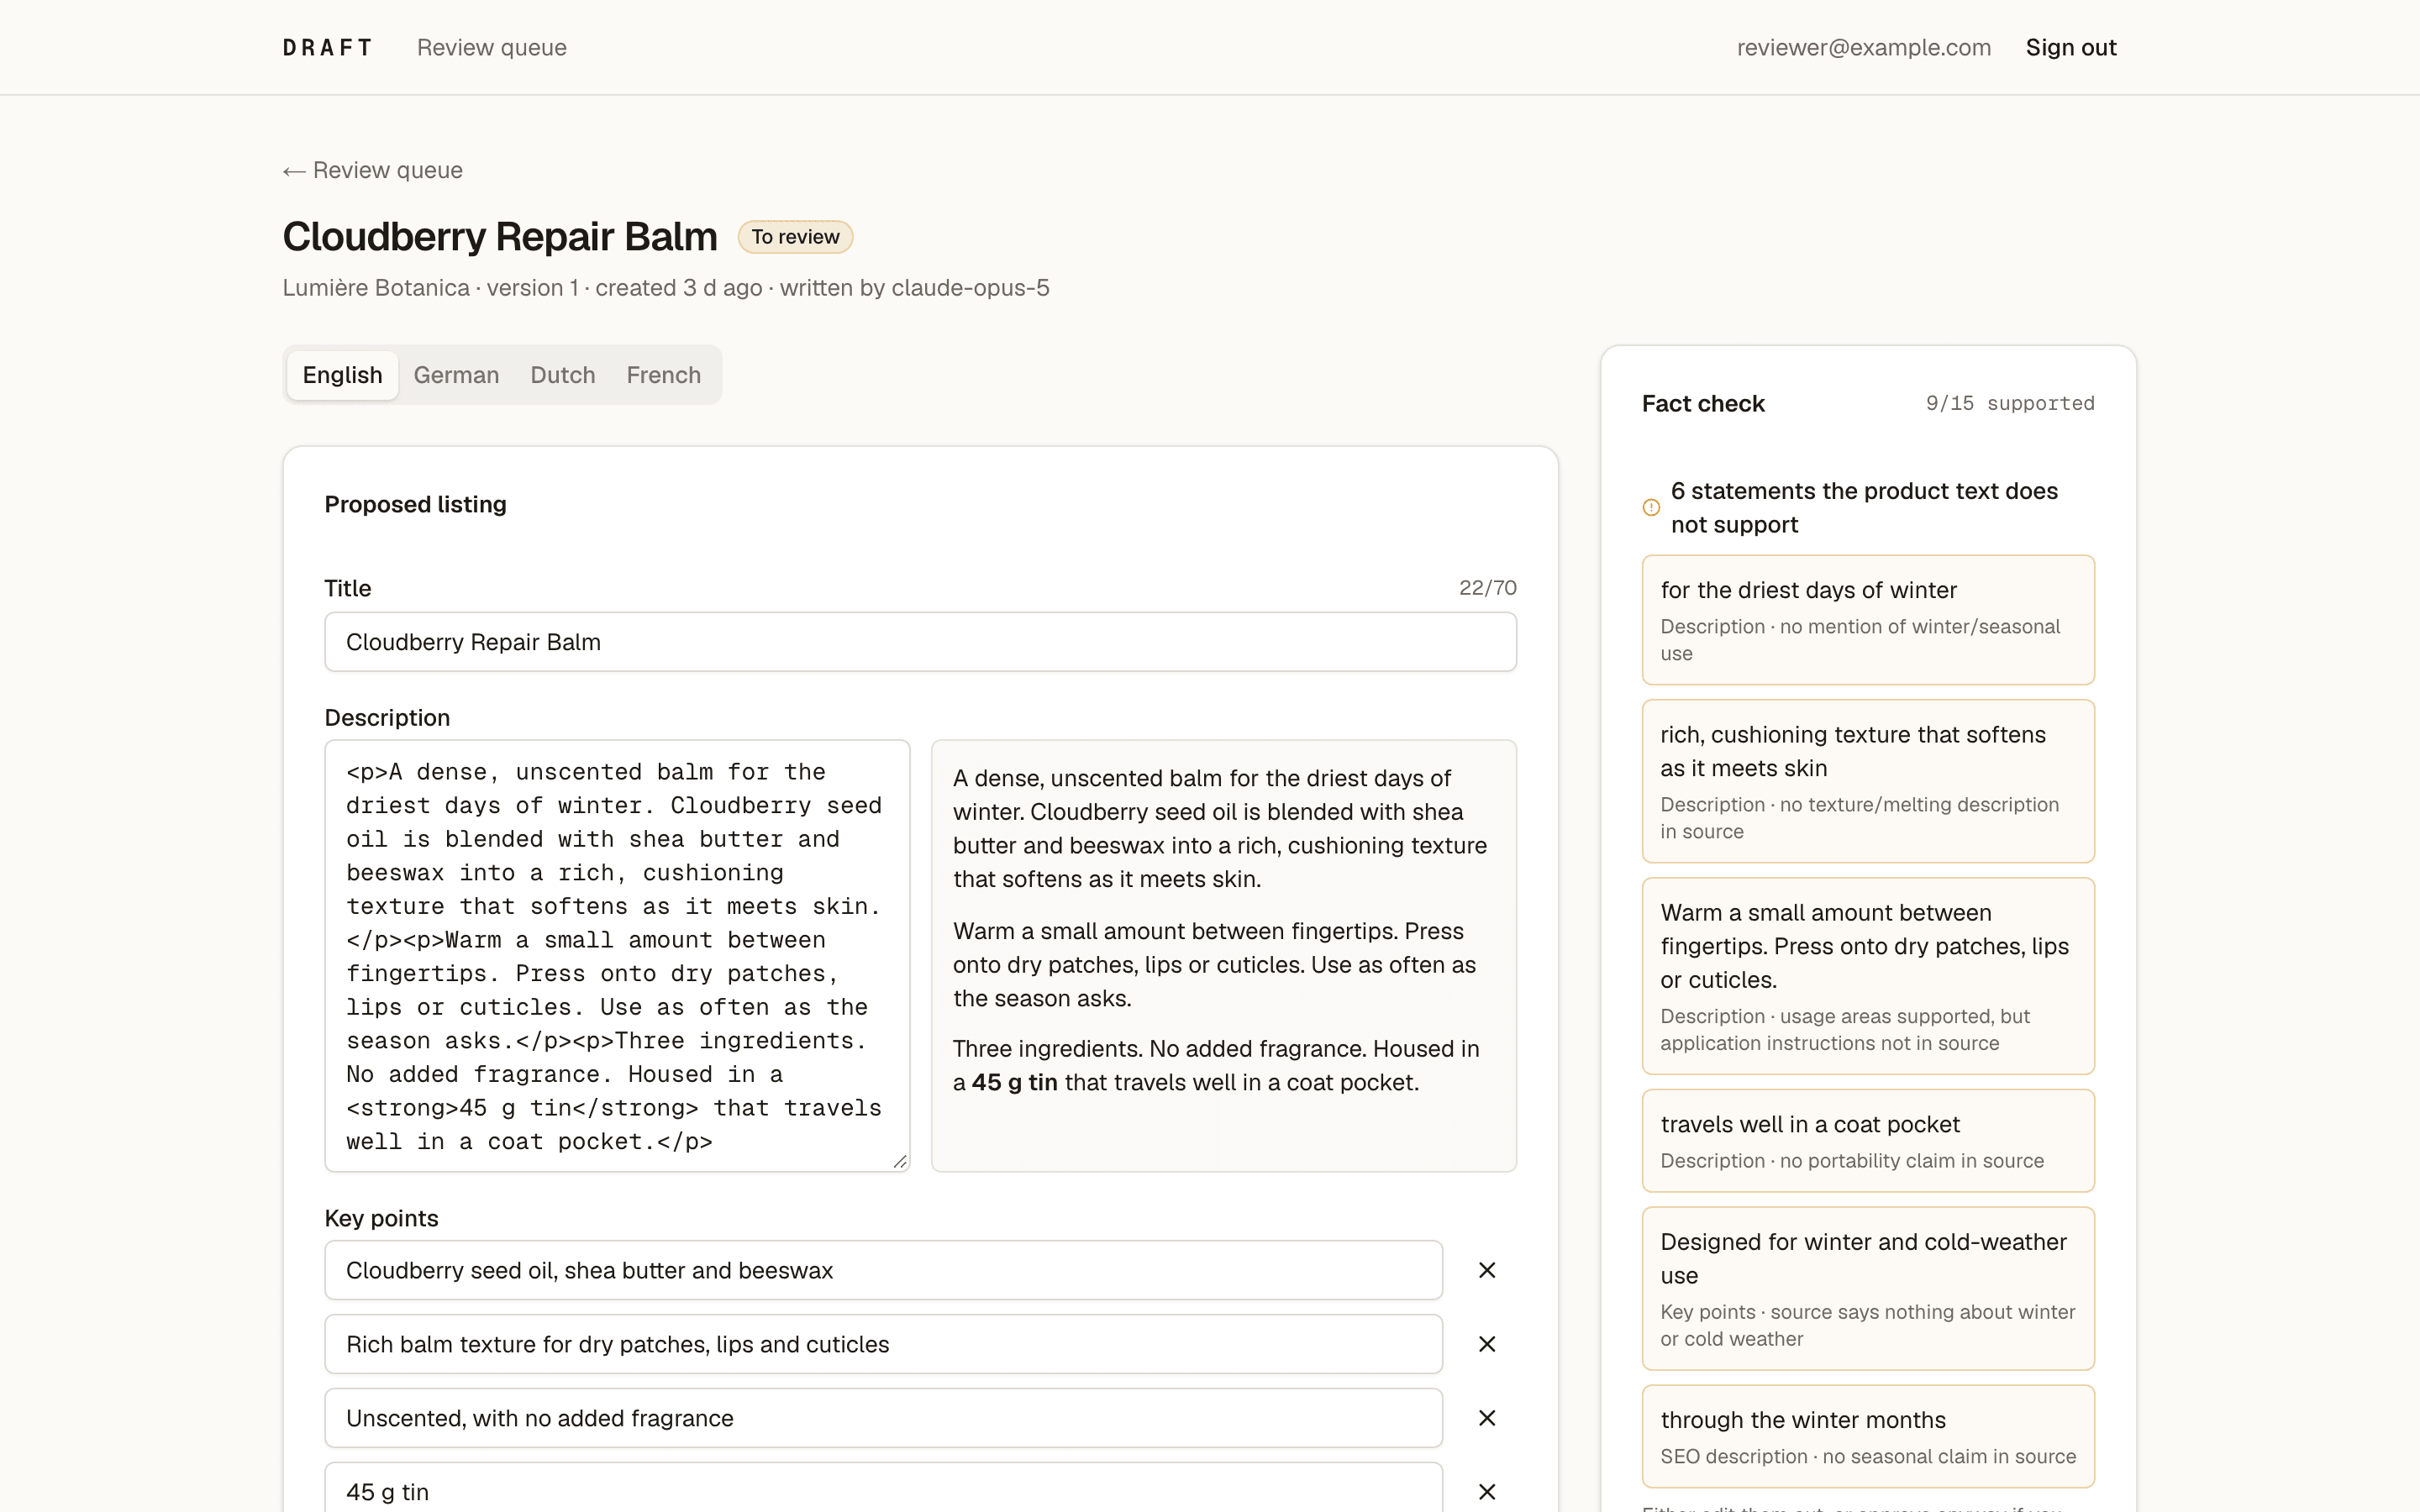
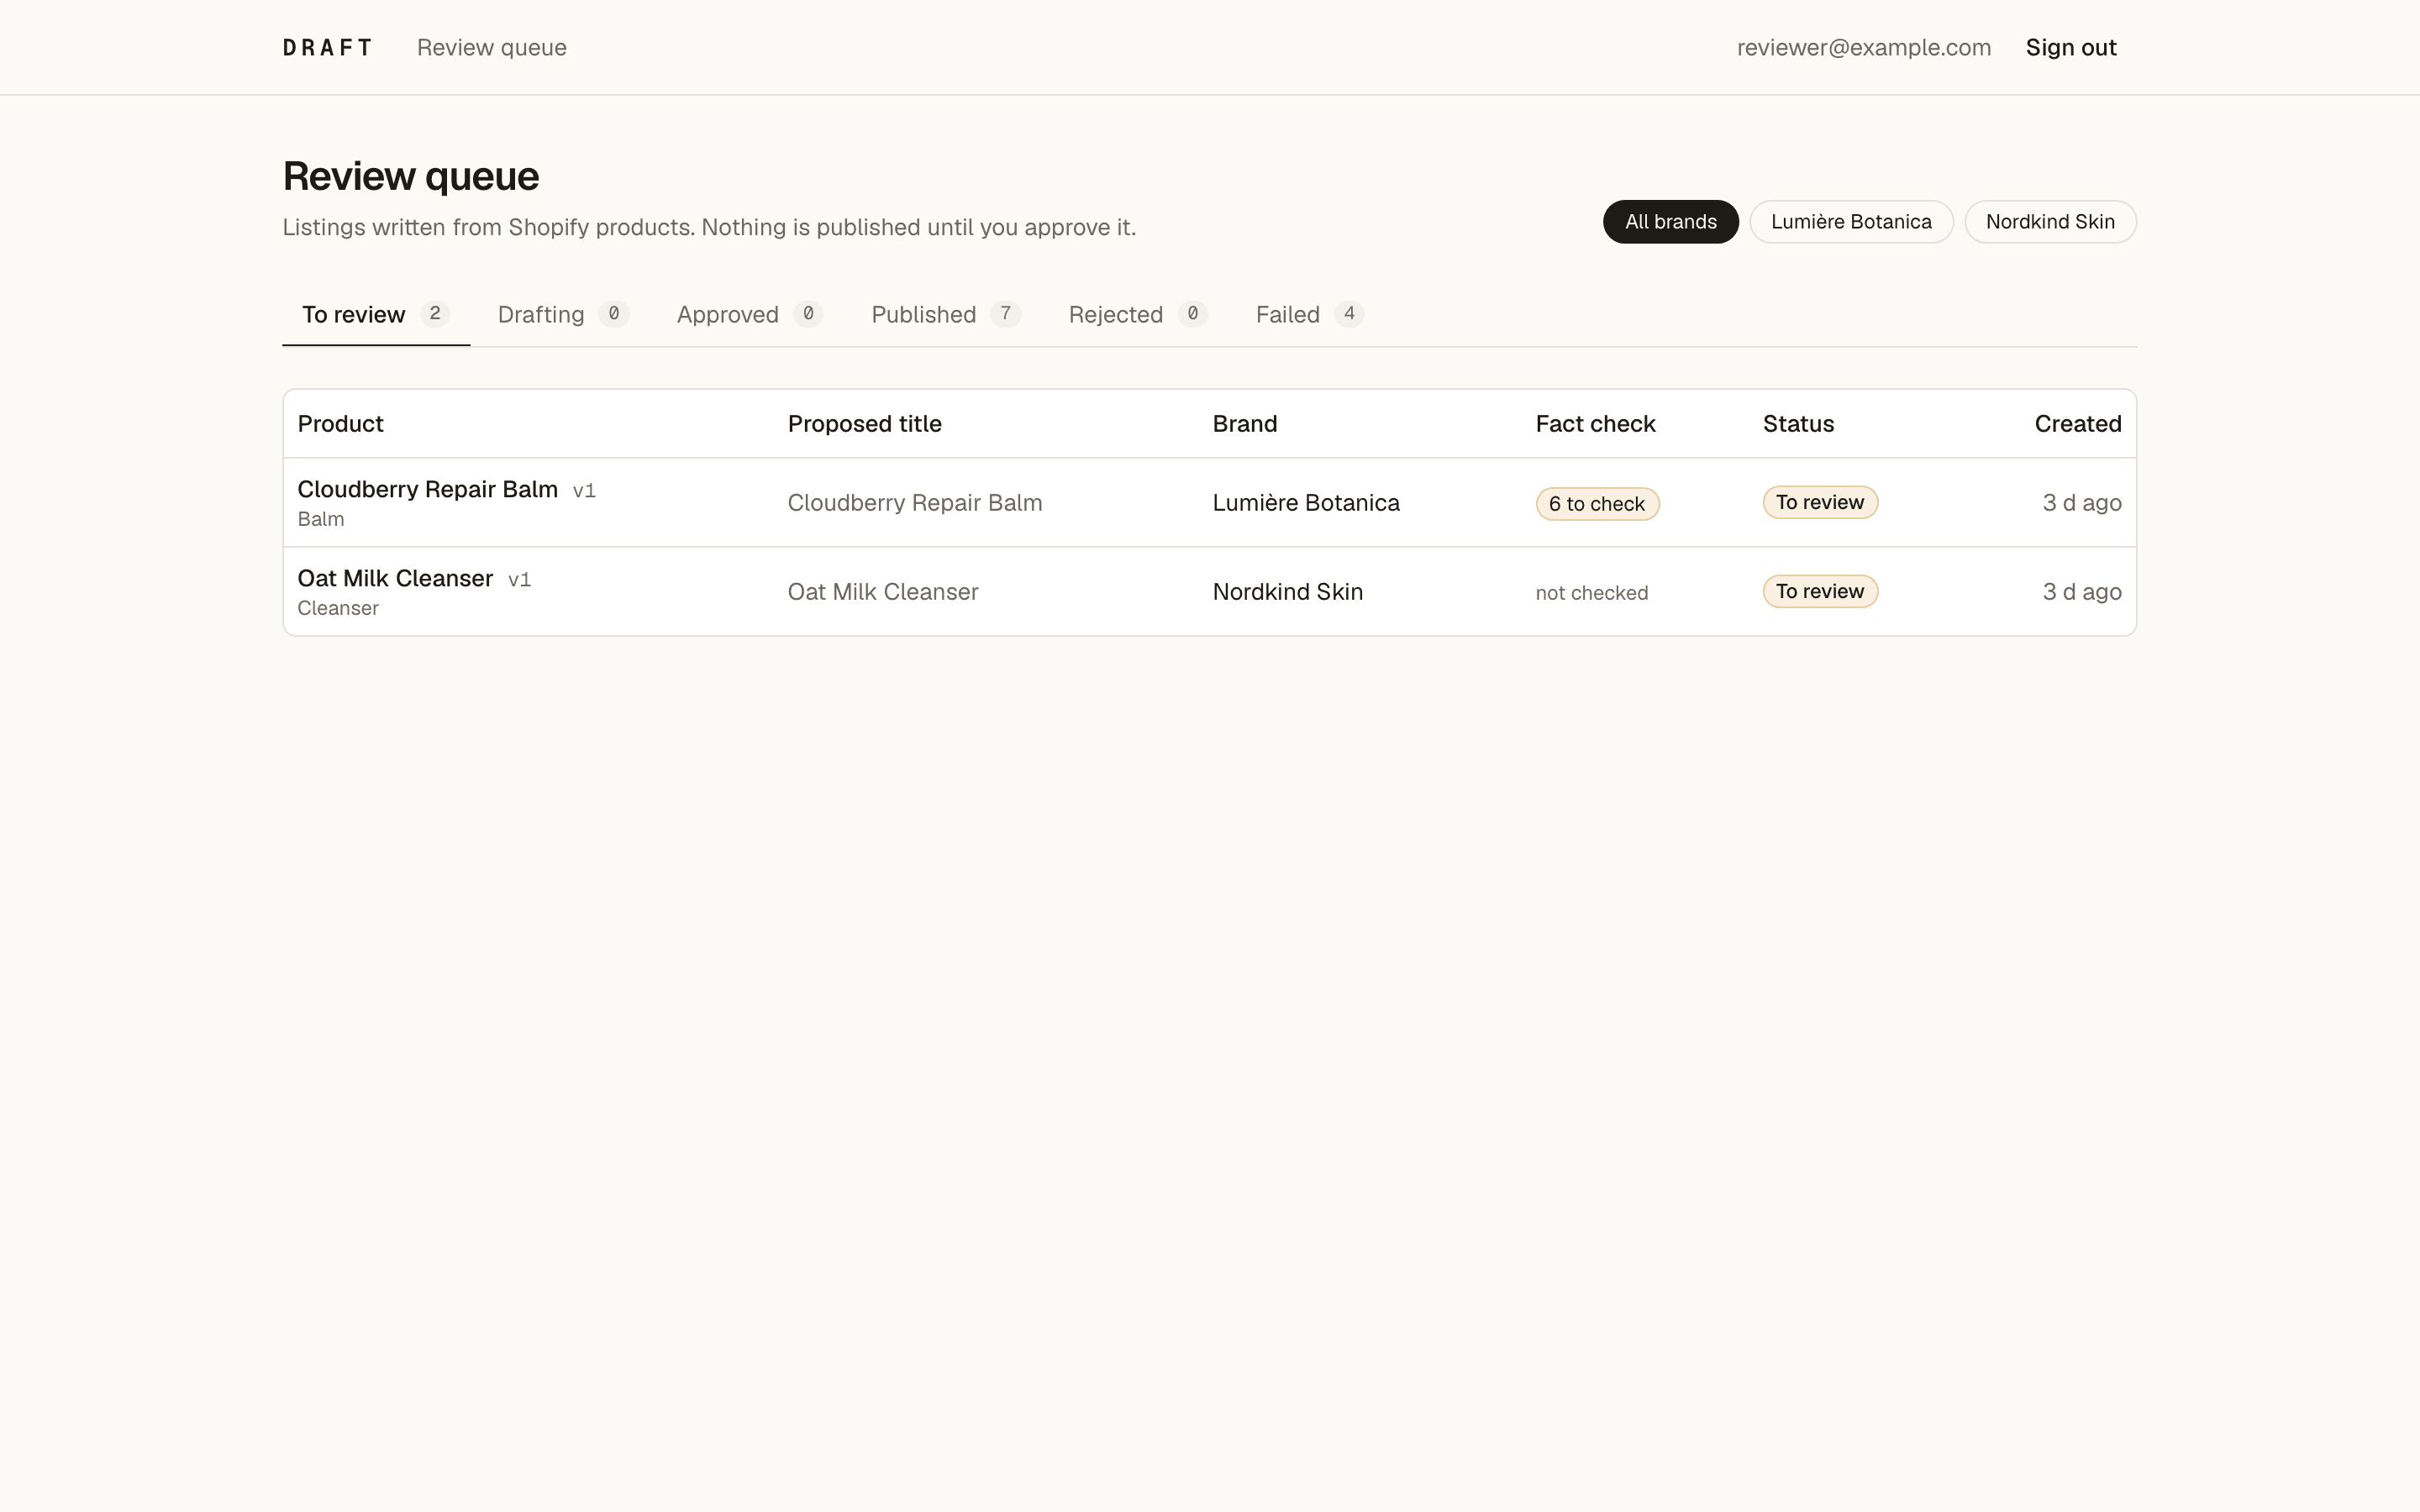
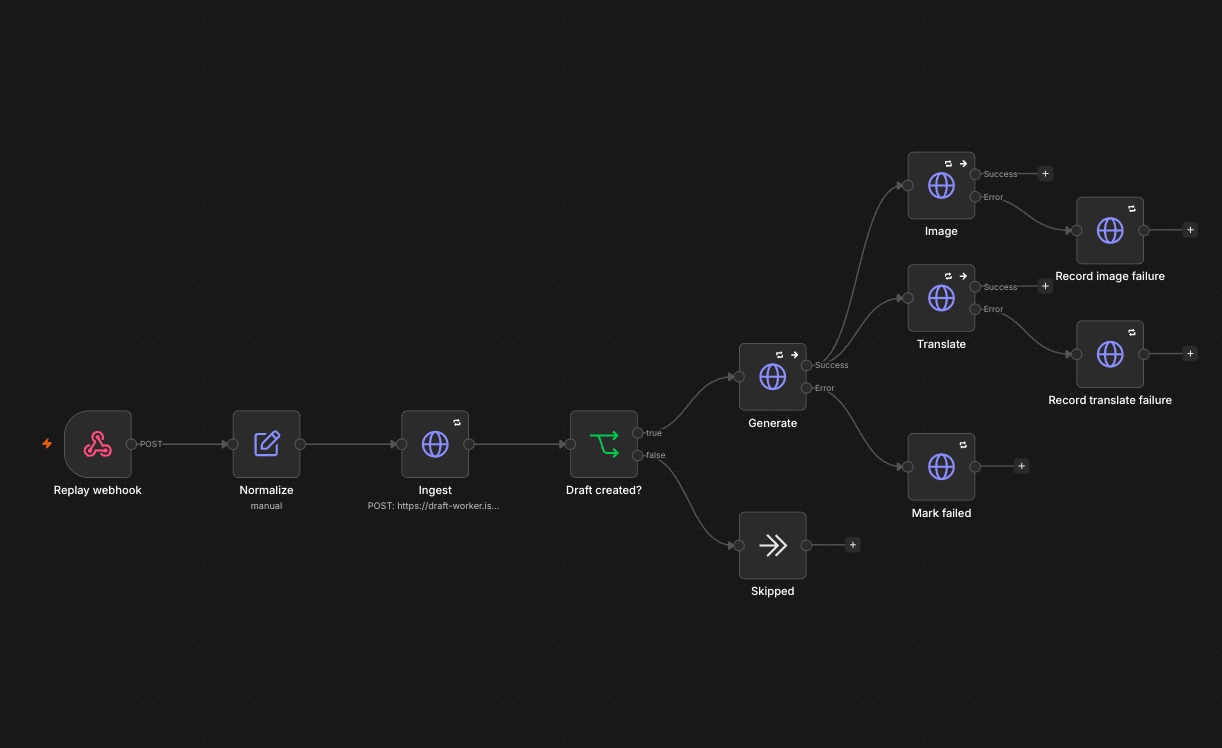
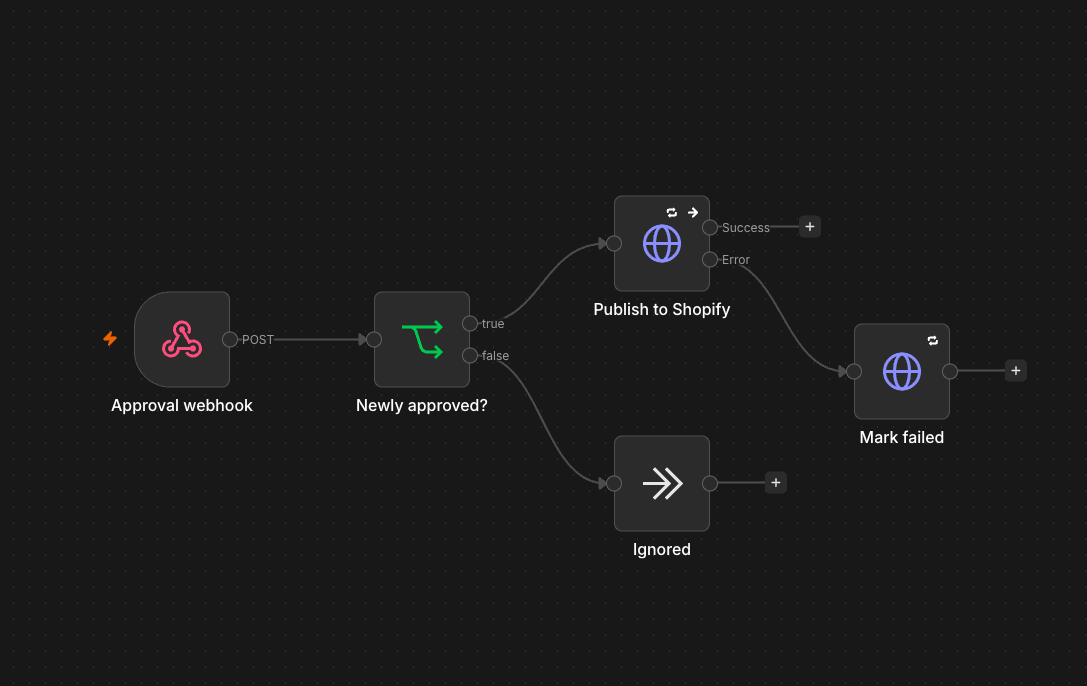
Twee n8n-workflows rond een Cloudflare Worker. De eerste vangt de Shopify-webhook op, maakt hem uniform en geeft hem door aan de Worker, die de pipeline bezit: ingest, genereren, vertalen, afbeelding. Elke stap heeft een eigen foutpad, dus een mislukte afbeelding wordt vastgelegd als een mislukte afbeelding in plaats van dat het concept verdwijnt. Claude schrijft de tekst en de vertalingen, Flux op Workers AI maakt de hero-afbeelding, Supabase houdt de status bij. De tweede workflow start zodra een reviewer goedkeurt en schrijft de producttekst en alle drie de vertalingen terug naar Shopify. Bij elk concept hoort een feitencheck: de output van het model gaat zin voor zin langs de brontekst van het product, en alles wat de bron niet onderbouwt wordt gemarkeerd met het veld waar het vandaan komt en de reden. De levenscyclus staat in Postgres en wordt afgedwongen met een trigger, en row level security houdt de wachtrij van elk merk bij de mensen die eraan werken. Dat is wat het volgende merk goedkoop maakt om toe te voegen.
Het resultaat
Die vier uur per dag zijn weg. Een gemeten run gaat van Shopify-webhook naar een producttekst die klaarligt voor review in 30,7 seconden, met drie vertalingen en een hero-afbeelding. Elke stap legt vast welk model hij gebruikte en hoe lang het duurde. Er gaat niets naar de webshop zonder mens, en omdat de feitencheck de niet-onderbouwde beweringen al heeft gemarkeerd, leest die mens een korte lijst in plaats van de hele producttekst opnieuw.